
AI 视频生成器到底对你的照片做了什么
所有 AI 视频生成器卖的都是同一个承诺:给它一张静图,还你几秒钟的动态。 但几乎没人告诉你中间发生了什么,也没人解释为什么同一张照片喂给两个工具, 出来的结果天差地别。
我们自己做了一个,所以能把过程摊开讲。
它要几分钟,不是几秒钟
这是最让人意外的一点。一条 5 秒 480p 的片子,我们实测下来是 158 秒和 168 秒, 差不多都是两分半到三分钟。
这里面几乎没有我们自己的代码。上传图片、校验格式、写进数据库,三件事加起来不到十秒。 剩下的全是模型在某块 GPU 上逐帧推理,以及排在其他同时点了生成的人后面。
所以当某个工具的进度条十五秒就冲到 99% 然后卡住不动,它不是坏了——它是在装样子。 任何诚实的 AI 视频生成器都会提前告诉你要等两到四分钟。
小幅动作看起来是真的,大幅动作不是
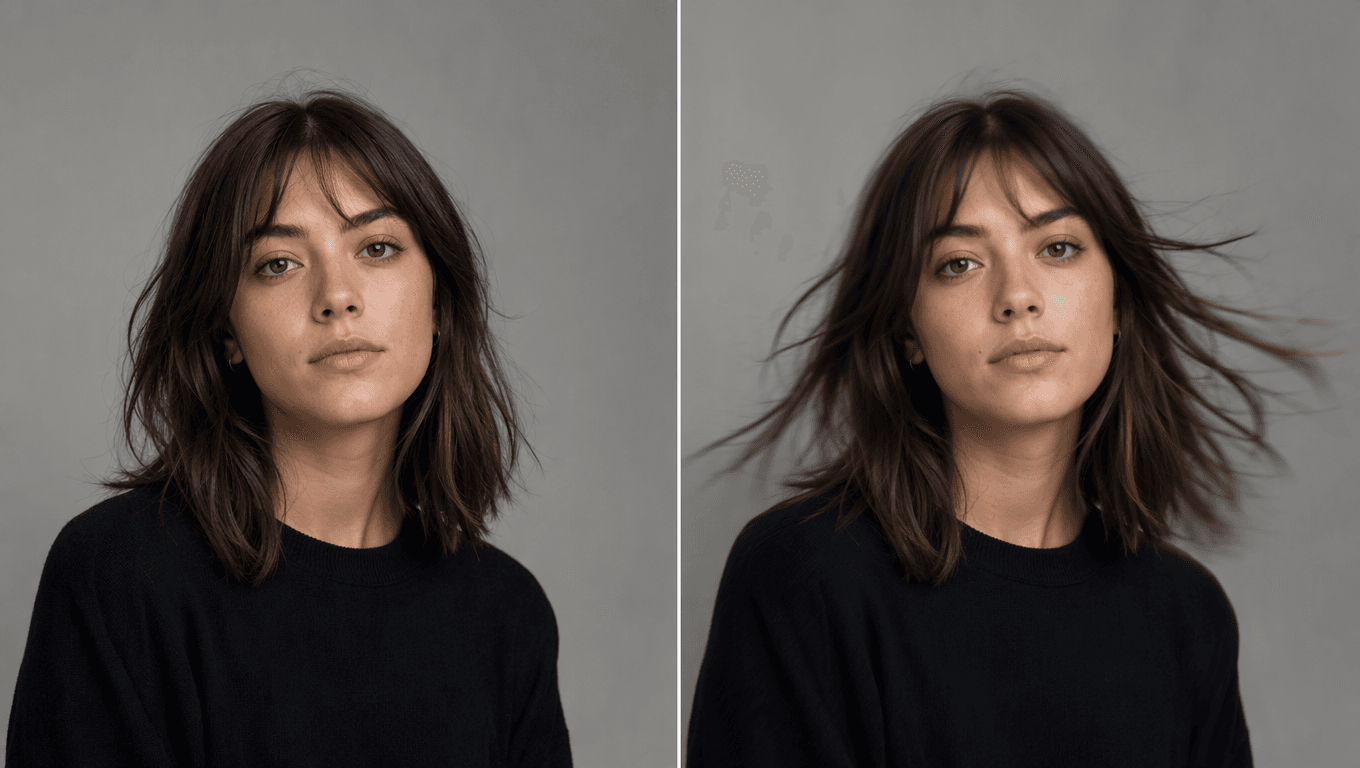
决定成片像不像真的,最大的变量是你让画面里的东西动多大。
人在呼吸、头发飘动、水汽升起、光在墙上缓慢移动——这些看起来真实, 是因为模型只需要凭空造出很小的变化,而这些变化跟原图是自洽的。 但如果你让同一个人转身、走到房间另一头、或者表情大变,模型就必须凭空发明 原图里根本不存在的信息:后脑勺、房间的另一半、牙齿。脸变形、手融化,都发生在这一步。
这不是花钱换个更好的模型就能绕过的限制。它是「模型手里只有一帧信息」的必然结果。
实用的原则是:在能讲清楚你想要的故事的前提下,要最小的那个动作。
提示词干的活比你以为的多
大多数人输入「让我的照片动起来」,然后根据结果判断这个工具行不行。 但这些模型是拿「视频 + 详细描述」配对训练出来的,含糊的提示词只会换来一个含糊的、 被平均掉的结果。
同一个生成器,这两句话的差别:
让我的猫动起来
和
从提供的首帧开始让猫动起来。镜头保持静止,猫眨眼、自然呼吸、耳朵轻微转动。 全程保持猫的外观、花纹和位置不变。环境音:安静的室内底噪。
第二句更好,原因藏在它的结构里。它把模型分开处理的四件事分开写了:
- 镜头怎么动 —— 静止、缓慢推进、环绕、手持跟拍
- 主体做什么 —— 具体的小动作,一个个点名
- 什么不许变 —— 外观、位置、构图
- 该有什么声音 —— 如果模型会生成音频
你不需要每次都写这么细。但如果某次结果让你失望,重写提示词几乎总是比换模型更快也更便宜。
钱花在分辨率上
生成是按输出秒数计价的,但真正把数字拉开的是分辨率,而且价差比大多数人预期的陡。 翻一遍各家模型的公开计费规则就会发现,同一条片子从 720p 升到 1080p,价格通常翻倍起步, 有的档位要贵上三四倍。时长一秒没变,只是每一帧里的像素多了。
值不值取决于这条片子最后在哪播:在手机屏幕上刷社交动态,720p 通常看不出区别; 要上大屏、或者是给客户的交付物,才有必要花这笔钱。
这也解释了为什么免费档普遍卡分辨率而不是卡时长——低分辨率的短片便宜到可以送, 同一条片子上到 1080p,就是另一个量级了。
用免费 AI 视频生成器之前该确认什么
免费在这个品类里是站得住的商业模式,一条低分辨率短片的成本小到可以送。 但细节差别很大:
- 水印。 有的工具把 logo 烧进文件里,有的只在预览播放器上盖一层,有的干脆没有。 把文件下载下来看一眼,别只看预览。
- 结果保留多久。 很多免费档 24 小时内就删掉生成的视频。立刻下载没问题, 关掉标签页第二天再来就没了。
- 你上传的照片去了哪。 你的照片会发给某个模型供应商。隐私政策里应该写明是哪家, 以及原图和成片各保存多久。
- 成片归谁。 这一条各家差别比想象中大,尤其是同一个产品的免费档和付费档之间。
一句话总结
AI 视频生成器不是魔法,也不是滤镜。它是一个模型在有根据地猜测: 你这张照片接下来几秒会是什么样。给它一个清晰的、小幅的、描述明确的变化,它猜得很准; 让它凭空发明一个没见过的场景,它就猜砸了。
想拿自己的照片试试,PhotoLoop 用一张图生成 5 秒免费短片——不用绑卡、没有水印, 只有想下载时才需要注册。